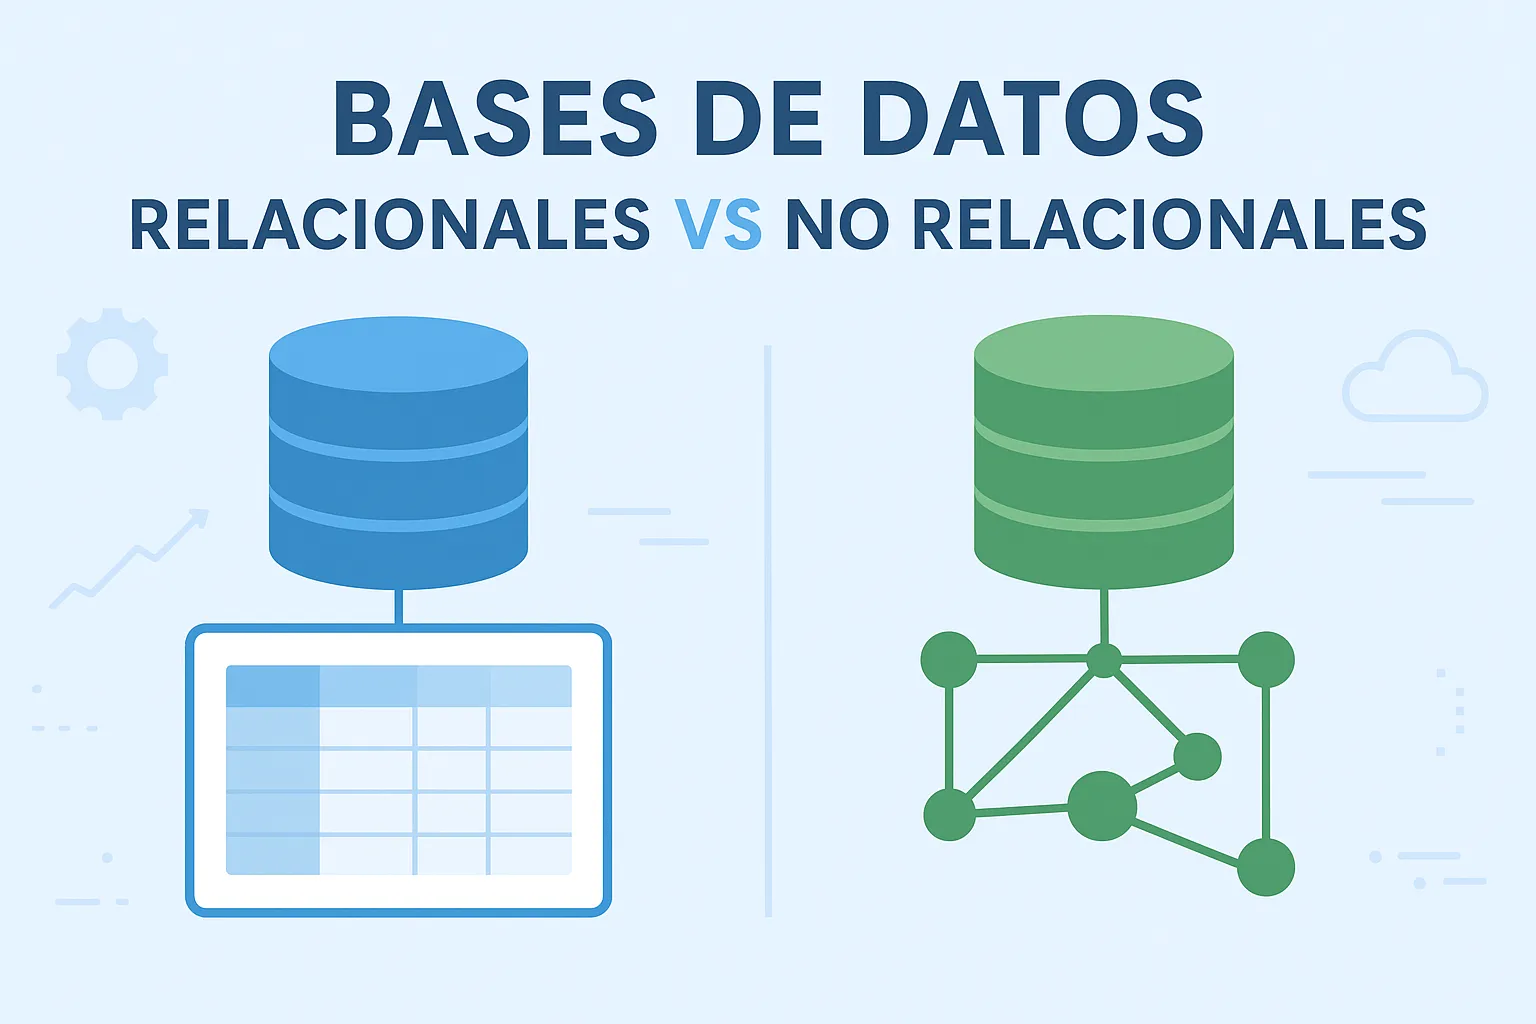
Elegir entre una base de datos relacional y una no relacional no consiste en escoger la tecnología más rápida o moderna. La decisión depende de cómo se relacionan los datos, qué consultas debe responder la aplicación, qué garantías necesitan las escrituras y qué sistema puede operar el equipo.
“No relacional” agrupa modelos distintos —documentos, clave-valor, columnas anchas y grafos—, así que no describe un único tipo de producto. Tampoco significa “sin transacciones” o “sin esquema”. Para comparar con precisión, conviene mirar el motor y el patrón de acceso que realmente se necesita.
Qué significa cada modelo
En el modelo relacional, la información se organiza en tablas. Las claves primarias identifican filas; las claves foráneas y restricciones expresan relaciones y reglas. SQL es el lenguaje más extendido para consultar y modificar estos datos.
Las bases no relacionales usan estructuras pensadas para otros patrones. Una base documental guarda documentos; una clave-valor recupera valores por una clave; una de columnas anchas distribuye tablas por particiones y consultas previstas; una de grafos representa entidades y relaciones como elementos del modelo.
| Modelo | Cómo organiza los datos | Ejemplos frecuentes |
|---|---|---|
| Relacional | Tablas, filas, columnas, claves y restricciones. | PostgreSQL, MySQL, SQL Server. |
| Documental | Documentos con campos y estructuras anidadas. | MongoDB. |
| Clave-valor | Valores consultados principalmente por una clave. | Redis. |
| Columnas anchas | Filas distribuidas y organizadas para consultas concretas. | Apache Cassandra. |
| Grafo | Nodos y relaciones con propiedades. | Neo4j. |
Estas categorías describen tendencias, no todas las capacidades de un producto. Algunos motores admiten varios modelos, ofrecen transacciones o incorporan interfaces de consulta adicionales.
Diferencias que sí afectan a la elección
| Criterio | Relacional | No relacional |
|---|---|---|
| Relaciones entre entidades | Claves, restricciones y joins permiten expresar relaciones y consultar datos relacionados. | Puede usar documentos embebidos, referencias, claves de partición o relaciones nativas de grafo; depende del modelo. |
| Esquema | Normalmente defines columnas, tipos y restricciones; las migraciones permiten evolucionar el esquema. | Puede aceptar estructuras flexibles, pero también admite validación y reglas. “Flexible” no quiere decir “sin diseño”. |
| Consultas | SQL ofrece una forma común de combinar, filtrar y agregar datos; cada motor tiene extensiones propias. | Las APIs y lenguajes varían; algunas soluciones ofrecen SQL o lenguajes parecidos. |
| Transacciones | Los motores relacionales suelen ser adecuados cuando una operación debe mantener juntas varias filas o tablas. El aislamiento y las garantías dependen del motor y la configuración. | Las capacidades varían: algunos sistemas soportan transacciones ACID en determinados ámbitos. Evalúa su alcance, coste y límites en el producto concreto. |
| Escalado | Puede escalar verticalmente o distribuirse; la partición horizontal exige diseño y operación específicos. | Algunos productos están diseñados para particionar y replicar datos, pero requieren modelar consultas y claves de partición. |
| Operación | Evalúa copias de seguridad, replicación, recuperación, migraciones y rendimiento del motor elegido. | Las mismas tareas siguen siendo necesarias; un clúster distribuido puede añadir complejidad de consistencia y operación. |
No confundas ACID con CAP
ACID describe propiedades de transacciones: atomicidad (todo o nada), consistencia (se respetan las reglas de integridad), aislamiento (se controla la interferencia entre operaciones concurrentes) y durabilidad (lo confirmado sobrevive según las garantías del sistema). Los niveles de aislamiento, los límites de una transacción y las condiciones de durabilidad varían entre motores.
El teorema CAP trata otro problema: durante una partición de red en un sistema distribuido, no se pueden garantizar al mismo tiempo que cada petición reciba respuesta y que cada respuesta refleje el dato más reciente. Es una forma de analizar decisiones ante fallos de comunicación; no clasifica todas las bases relacionales como consistentes ni todas las NoSQL como disponibles.
Cuándo puede encajar cada modelo
Pagos, pedidos e inventario
Si una compra debe reservar existencias, crear el pedido y registrar el pago como una operación coherente, empieza evaluando una base relacional: las relaciones, restricciones y transacciones suelen encajar bien con ese límite de consistencia. Revisa qué partes de la operación deben confirmarse juntas y qué ocurre si una de ellas falla.
Sesiones, caché y búsquedas por clave
Una estructura clave-valor puede ser adecuada si la aplicación recupera sesiones o elementos de caché por una clave conocida, con expiración y baja latencia. Si esos datos son la fuente principal y no pueden perderse, comprueba persistencia, replicación, recuperación y garantías de escritura; no los trates como una caché desechable.
Catálogos con atributos variables
Un modelo documental puede facilitar el almacenamiento de productos con atributos distintos y de información que suele leerse junta. Aun así, hay que definir validaciones, índices y cómo se actualizan campos repetidos. Si el catálogo también participa en operaciones de inventario o facturación, separa con claridad qué sistema es dueño de cada dato.
Relaciones que se recorren en profundidad
Una base de grafos puede simplificar consultas sobre caminos y conexiones de varias etapas —por ejemplo, dependencias, recomendaciones o relaciones entre personas—. Si la aplicación solo necesita unas pocas uniones conocidas, una base relacional puede resolverlo sin incorporar un motor adicional.
Telemetría y eventos distribuidos
Una base de columnas anchas puede servir para grandes flujos de escrituras con consultas previamente definidas por dispositivo, partición o intervalo temporal. Este patrón exige elegir bien las claves y aceptar sus reglas de consulta y consistencia; el volumen por sí solo no basta para justificarla.
Criterios prácticos para decidir
- Escribe las consultas principales que la aplicación debe responder; diseña desde esas consultas, no desde una etiqueta tecnológica.
- Define qué datos cambian juntos y qué debe ocurrir si una escritura falla a mitad de camino.
- Determina si las relaciones se consultan con joins, búsquedas por clave, documentos embebidos o recorridos de grafo.
- Estima crecimiento, distribución geográfica, concurrencia y latencia con una carga representativa, no solo con una proyección de volumen.
- Compara herramientas de migración, monitorización, copia de seguridad, recuperación y experiencia del equipo.
- Prueba el modelo con datos y consultas realistas; mide lecturas, escrituras, índices y coste operativo antes de comprometerte.
¿Tiene sentido combinar ambas?
Sí, si cada motor resuelve una necesidad concreta que el otro cubre peor. Una aplicación puede mantener pedidos en una base relacional y usar una base de grafos para explorar relaciones. La combinación añade sincronización, copias, supervisión y posibles retrasos entre sistemas: define cuál es la fuente de verdad y cómo se corrigen discrepancias. “Usar dos bases” no es una mejora automática.
Para muchos proyectos, una sola base de datos conocida por el equipo es el mejor punto de partida. Añade otro modelo cuando una necesidad medida lo justifique y puedas describir cómo se operará.
Referencias
- Documentación de PostgreSQL sobre restricciones: claves y reglas de integridad relacional.
- Tutorial de transacciones de PostgreSQL: operaciones agrupadas y transacciones SQL.
- Modelado de datos en MongoDB: documentos, relaciones y esquemas flexibles.
- Transacciones en MongoDB: capacidades y consideraciones según el despliegue.
- Modelado de datos en Apache Cassandra: diseño guiado por consultas.
- Conceptos de bases de datos de grafos en Neo4j: nodos, relaciones y propiedades.
👉 Y recuerda, si quieres aprender más de Linux, visita el curso de Linux gratis.
🐳 Si quieres aprender más de Docker, visita el curso de Docker gratis.