Saber cómo configurar políticas de reinicio en Docker te ayuda a decidir qué debe pasar cuando un contenedor se detiene: quedarse apagado, reiniciarse si falla o volver a arrancar después de reiniciar el daemon.
Una política de reinicio no arregla una aplicación rota. Sirve para controlar el comportamiento del contenedor ante fallos, reinicios del host o salidas inesperadas. Si se usa mal, puede ocultar errores reales en un bucle infinito.
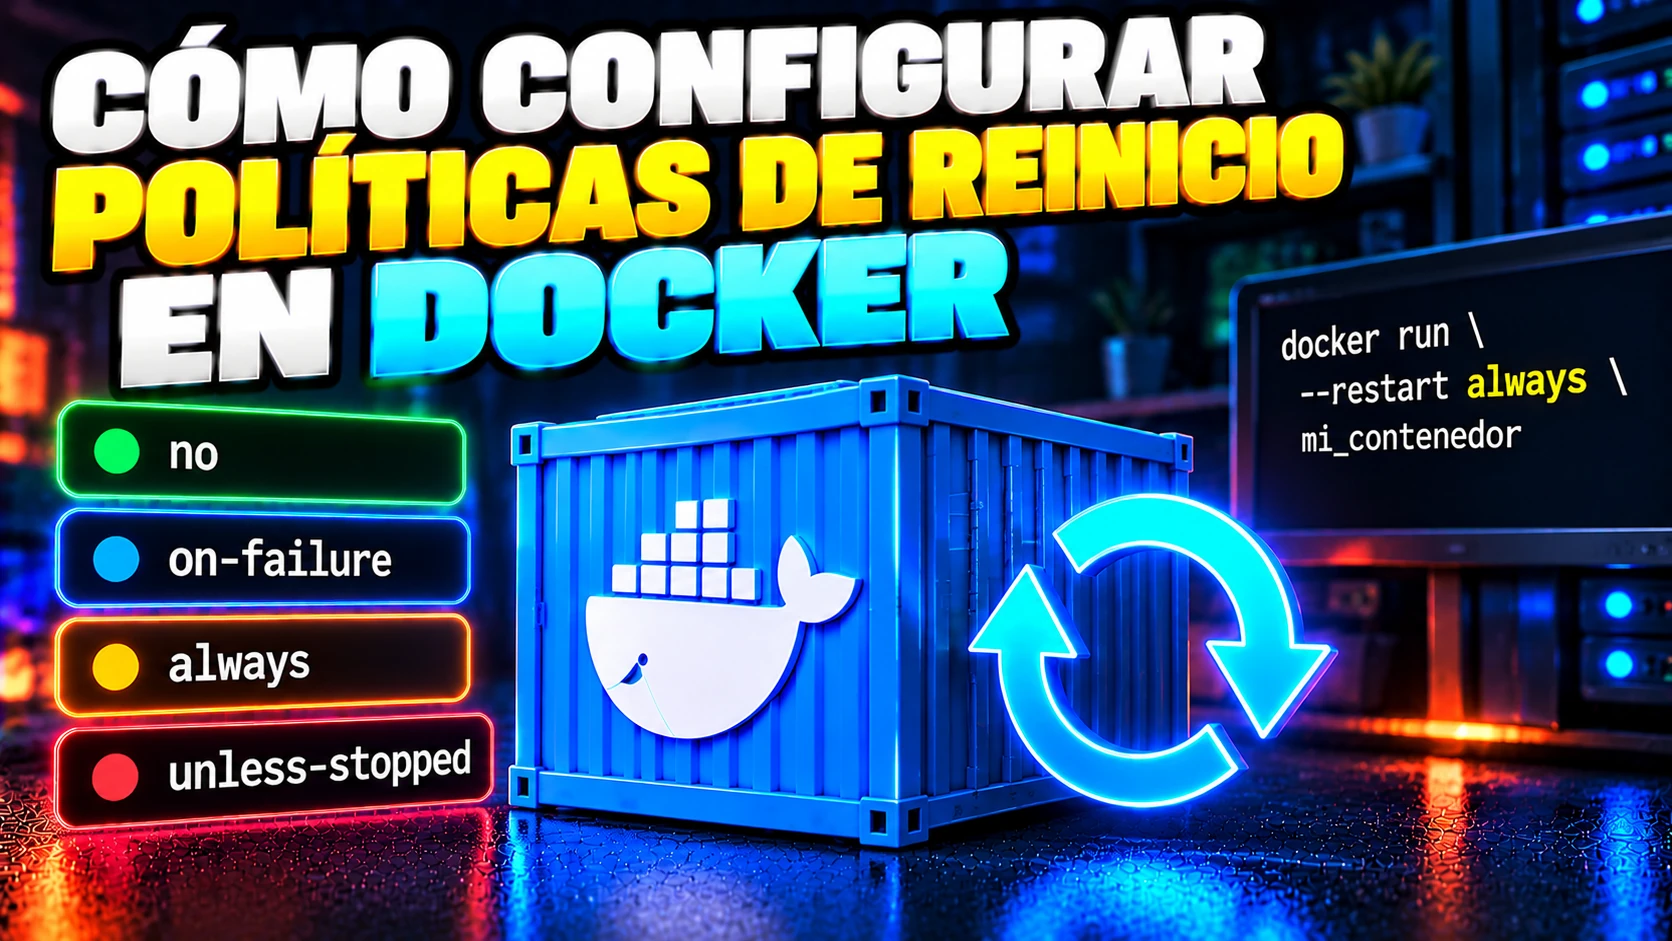
En esta lección vas a aprender cómo configurar políticas de reinicio en Docker, qué diferencias hay entre no, on-failure, always y unless-stopped, y cómo verificar la política aplicada.
👉 Y recuerda, si quieres aprender más de Linux, visita el curso de Linux gratis.
🐳 Si quieres aprender más de Docker, visita el curso de Docker gratis.
Configurar políticas de reinicio en Docker
La forma directa de configurar una política al crear un contenedor es usar la opción –restart. Esta opción define cómo debe reaccionar Docker si el contenedor termina. Por eso, cómo configurar políticas de reinicio en Docker debe entenderse como una decisión operativa, no solo como una opción de la CLI.
docker run -d --name web --restart unless-stopped nginx:alpineEn este ejemplo, el contenedor se ejecuta en segundo plano y Docker intentará mantenerlo disponible salvo que tú lo detengas explícitamente.
| Política | Qué hace | Cuándo usarla |
|---|---|---|
| no | No reinicia el contenedor automáticamente. | Tareas puntuales o pruebas manuales. |
| on-failure | Reinicia solo si el proceso termina con error. | Servicios donde una salida correcta debe respetarse. |
| always | Intenta reiniciar siempre que el contenedor se detenga. | Servicios que deben volver incluso tras reiniciar Docker. |
| unless-stopped | Reinicia salvo que lo hayas detenido manualmente. | Opción habitual para servicios persistentes. |
Usar on-failure con límite de intentos
Cuando una aplicación puede fallar al arrancar, on-failure permite reiniciarla solo si el proceso termina con error. También puedes limitar el número de intentos para evitar bucles interminables.
docker run -d --name worker --restart on-failure:3 alpine:3.20 sh -c "exit 1"Este ejemplo es de laboratorio: el comando termina con error y Docker intentará reiniciarlo hasta el límite indicado. En un servicio real, revisa logs antes de aumentar intentos.
Diferencia entre always y unless-stopped
always intenta devolver el contenedor a ejecución incluso después de reiniciar el daemon. unless-stopped se parece, pero respeta mejor la intención del administrador cuando el contenedor fue detenido manualmente.
docker run -d --name servicio-always --restart always nginx:alpine
docker run -d --name servicio-unless --restart unless-stopped nginx:alpinePara muchos laboratorios y servicios persistentes, unless-stopped suele ser más cómodo porque evita que un contenedor detenido a propósito vuelva inesperadamente tras reiniciar Docker.
Cambiar la política de un contenedor existente
Si el contenedor ya existe, no siempre necesitas recrearlo. Puedes actualizar la política con docker update y verificarla después con docker inspect.
docker update --restart unless-stopped nombre_contenedor
docker inspect nombre_contenedor --format "RestartPolicy={{.HostConfig.RestartPolicy.Name}} MaximumRetryCount={{.HostConfig.RestartPolicy.MaximumRetryCount}}"Este cambio afecta al comportamiento futuro. No soluciona por sí solo la causa del fallo; solo define qué hará Docker si el contenedor vuelve a detenerse.
Políticas de reinicio con Docker Compose
En proyectos Compose, declara la política en el archivo del servicio. Así el comportamiento queda versionado junto con el resto de la configuración.
services:
  web:
    image: nginx:alpine
restart: unless-stoppedEvita configurar la política a mano si el servicio se gestiona con Compose, porque el próximo despliegue puede sobrescribir o contradecir el cambio manual.
Verificar reinicios y diagnosticar bucles
Una política de reinicio puede convertir un fallo en un bucle rápido. Por eso debes revisar estado, contador de reinicios y logs cuando un servicio no se mantiene estable.
docker ps -a
docker inspect nombre_contenedor --format "Status={{.State.Status}} Restarting={{.State.Restarting}} RestartCount={{.RestartCount}}"
docker logs --tail 100 nombre_contenedorSi RestartCount sube continuamente, no lo tapes aumentando la política de reinicio. Primero investiga por qué el proceso principal termina.
Errores comunes con políticas de reinicio
El error más peligroso es usar always para ocultar una aplicación que falla. El contenedor parecerá intentar recuperarse, pero los logs mostrarán el mismo error una y otra vez.
Otro error es aplicar una política de reinicio a trabajos que deben terminar. Si un contenedor ejecuta una tarea puntual y termina correctamente, quizá no debe reiniciarse.
También conviene distinguir reiniciar un contenedor de resolver la causa. Si el problema es una variable ausente, permisos incorrectos o una base de datos inaccesible, la política solo repetirá el fallo.
Lecciones relacionadas del curso Docker
- Cómo reiniciar contenedores Docker
- Cómo investigar un contenedor detenido en Docker
- Por qué un contenedor se apaga cuando termina su proceso
- Cómo ver logs de un contenedor Docker
- Cómo inspeccionar un contenedor Docker
Documentación oficial y recursos
- Docker Docs: start containers automatically
- Docker CLI: docker run
- Docker CLI: docker update
- Compose Specification: restart
En resumen, cómo configurar políticas de reinicio en Docker consiste en elegir un comportamiento acorde al tipo de servicio. Un demonio persistente no necesita la misma política que una tarea puntual.
Usa la política como mecanismo de recuperación, no como sustituto del diagnóstico. Si un contenedor entra en bucle, revisa logs, estado y configuración antes de declarar que el problema está solucionado.